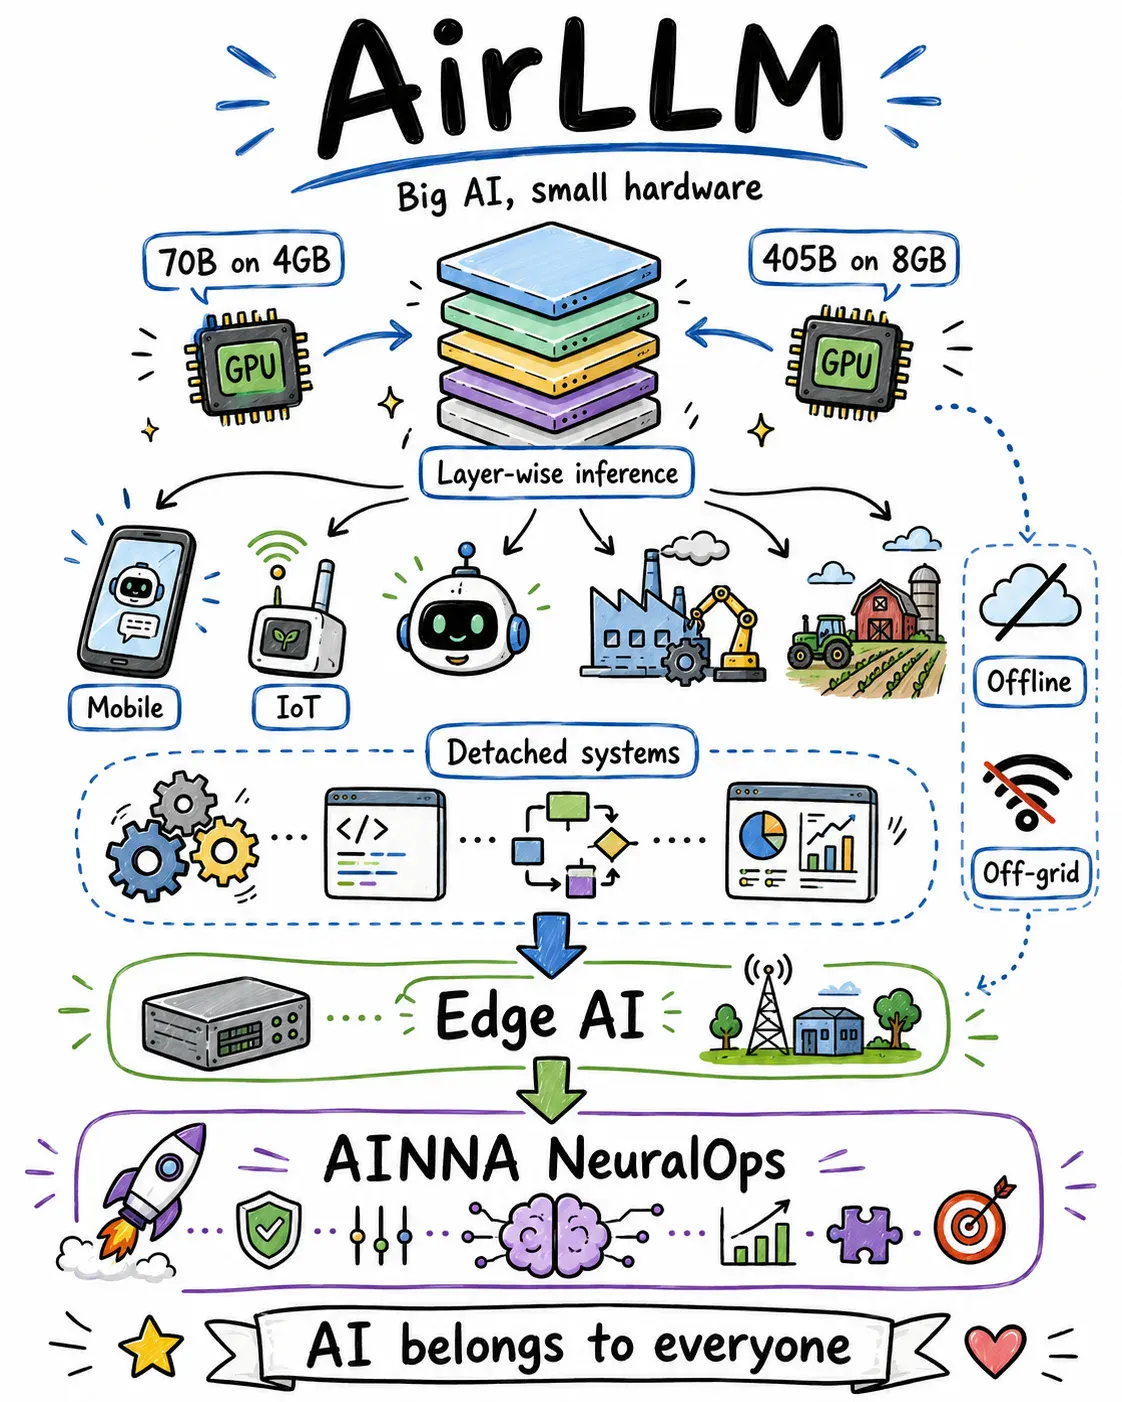
AirLLM mungkin jadi satu anjakan besar dalam cara kita lihat infrastruktur AI.
Kini kita boleh jalankan model 70B hanya dengan GPU 4GB, dan boleh skala eksperimen ke arah Llama 3.1 405B menggunakan VRAM 8GB sahaja - ini bukan sekadar hype, tetapi anjakan seni bina yang serius.
Selama bertahun-tahun, AI berkuasa terasa seperti hak milik syarikat teknologi gergasi, hyperscaler, dan organisasi yang ada GPU besar, bajet cloud besar, serta akses data center. Yang lain pada dasarnya menyewa kecerdasan mengikut token.
Tapi cerita itu berubah pantas. Dengan inferens layer-wise, pengurusan memori yang lebih pintar, dan inovasi open-source, model besar semakin mudah diakses oleh pembangun biasa, 中小企业, pelajar, penyelidik, dan komuniti tech tempatan.
变化 sebenar bukan sekadar model lebih besar. Ia terletak pada cara kita jalankan model - lebih ringan, lebih pintar, lebih lokal, lebih cekap, dan lebih praktikal untuk penggunaan dunia nyata.
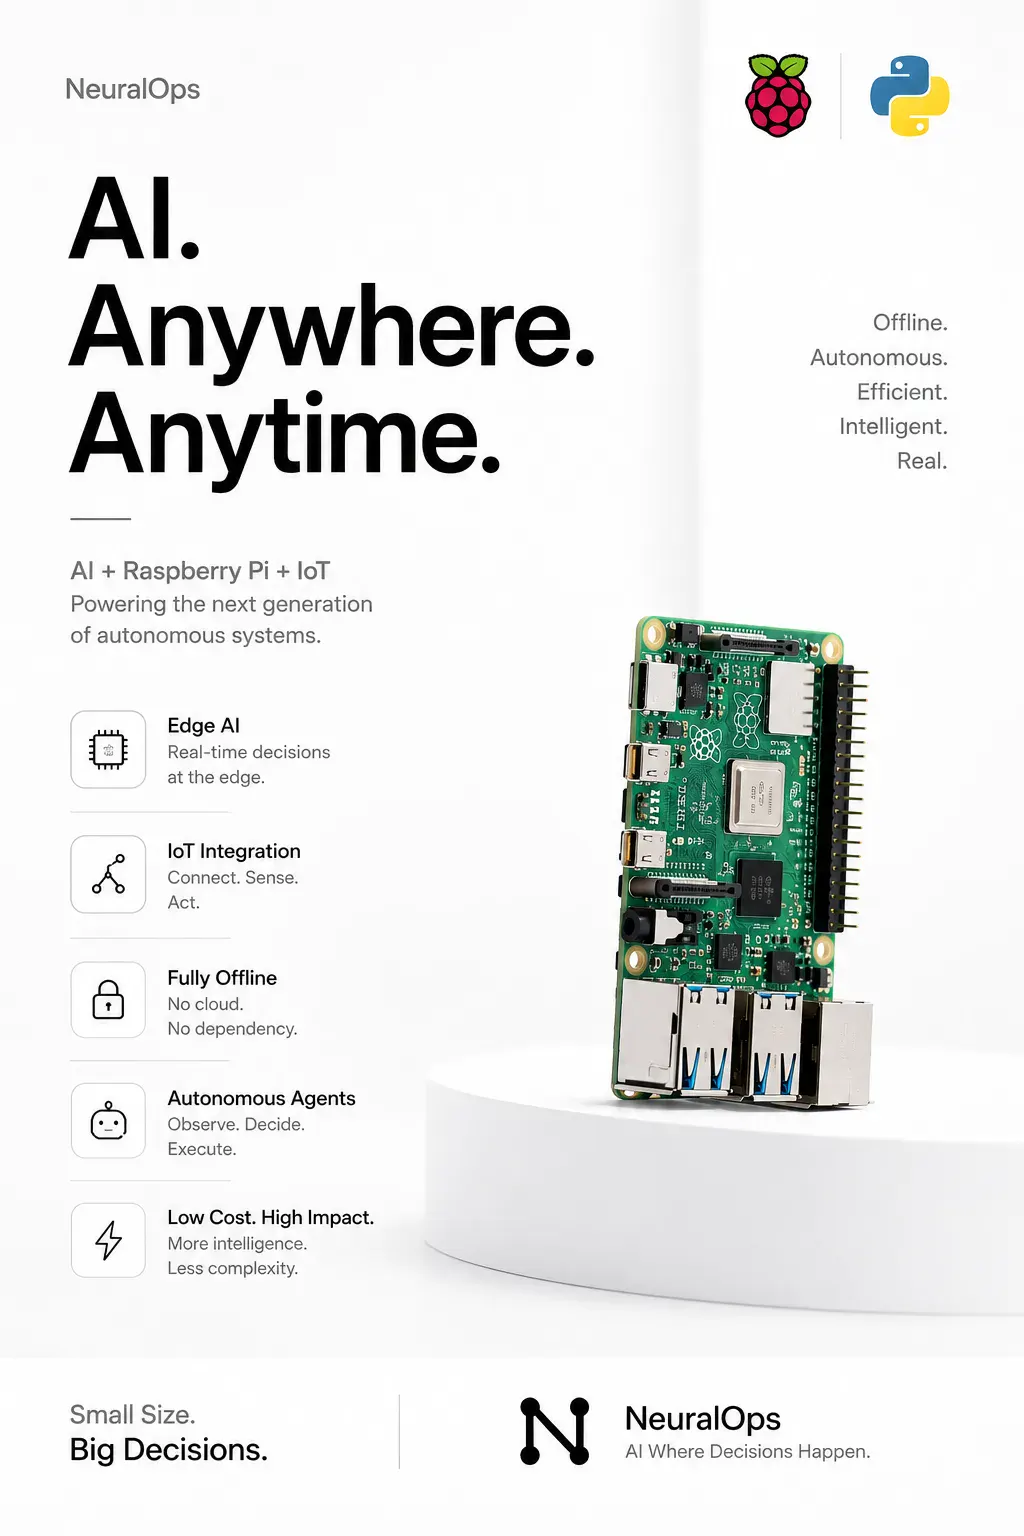
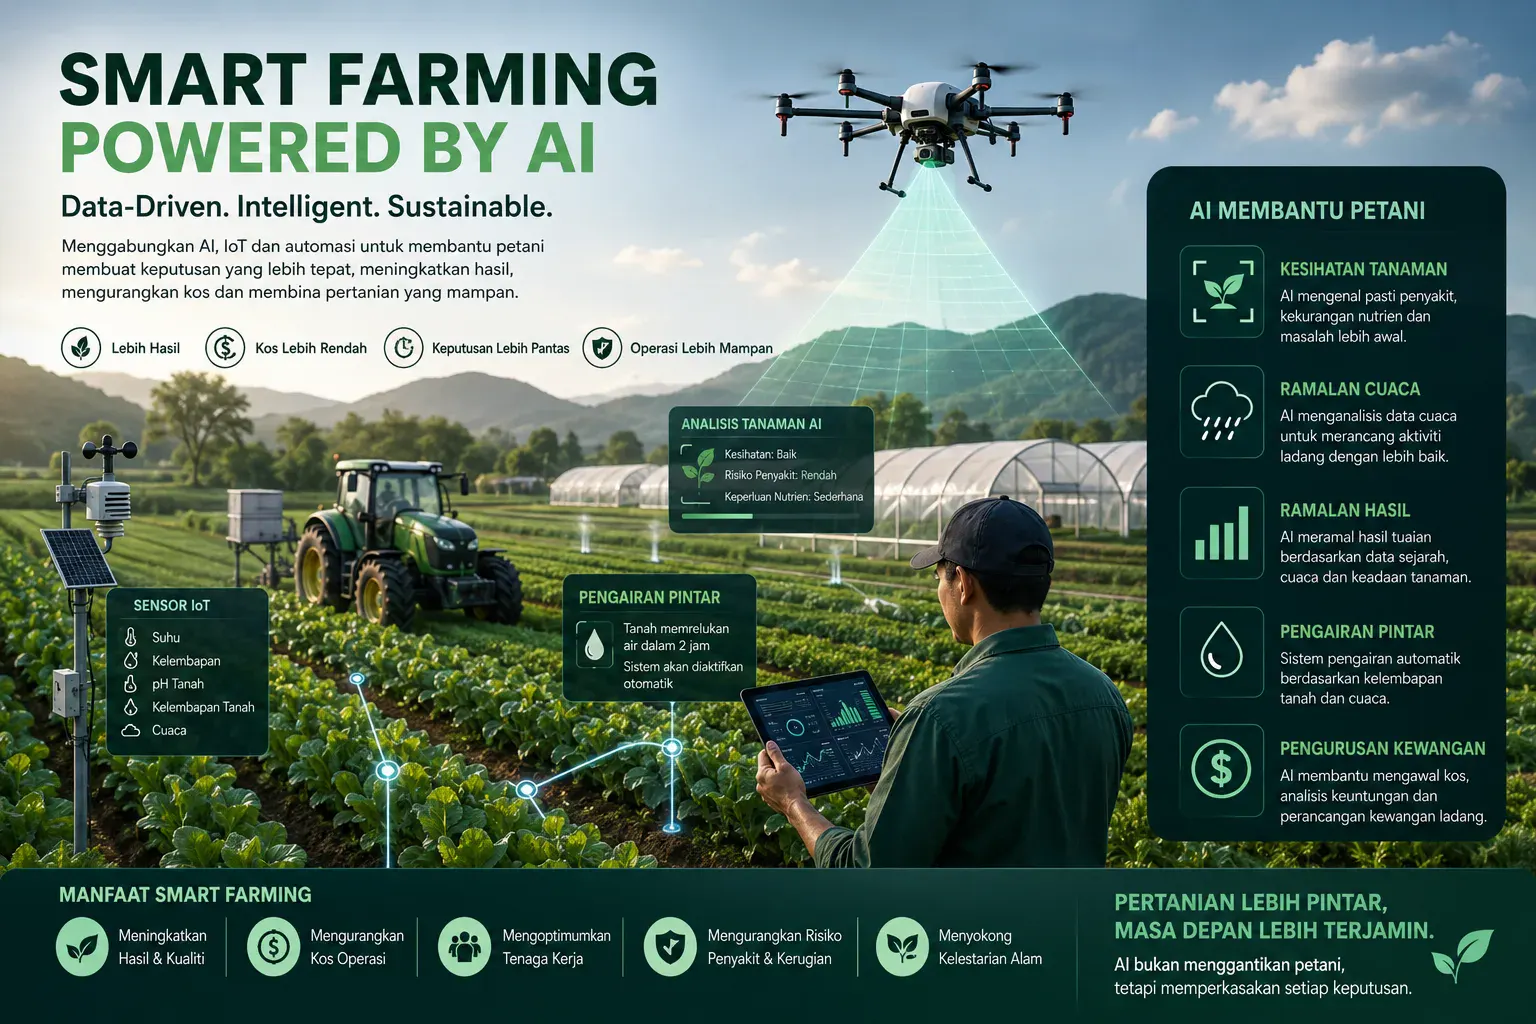
Di sinilah 边缘 AI dan AINNA NeuralOps berperanan. Daripada bergantung sepenuhnya kepada cloud AI, kecerdasan boleh digerakkan lebih dekat ke peranti, sensor, mesin, ladang, kilang, dan operasi sebenar di lapangan.
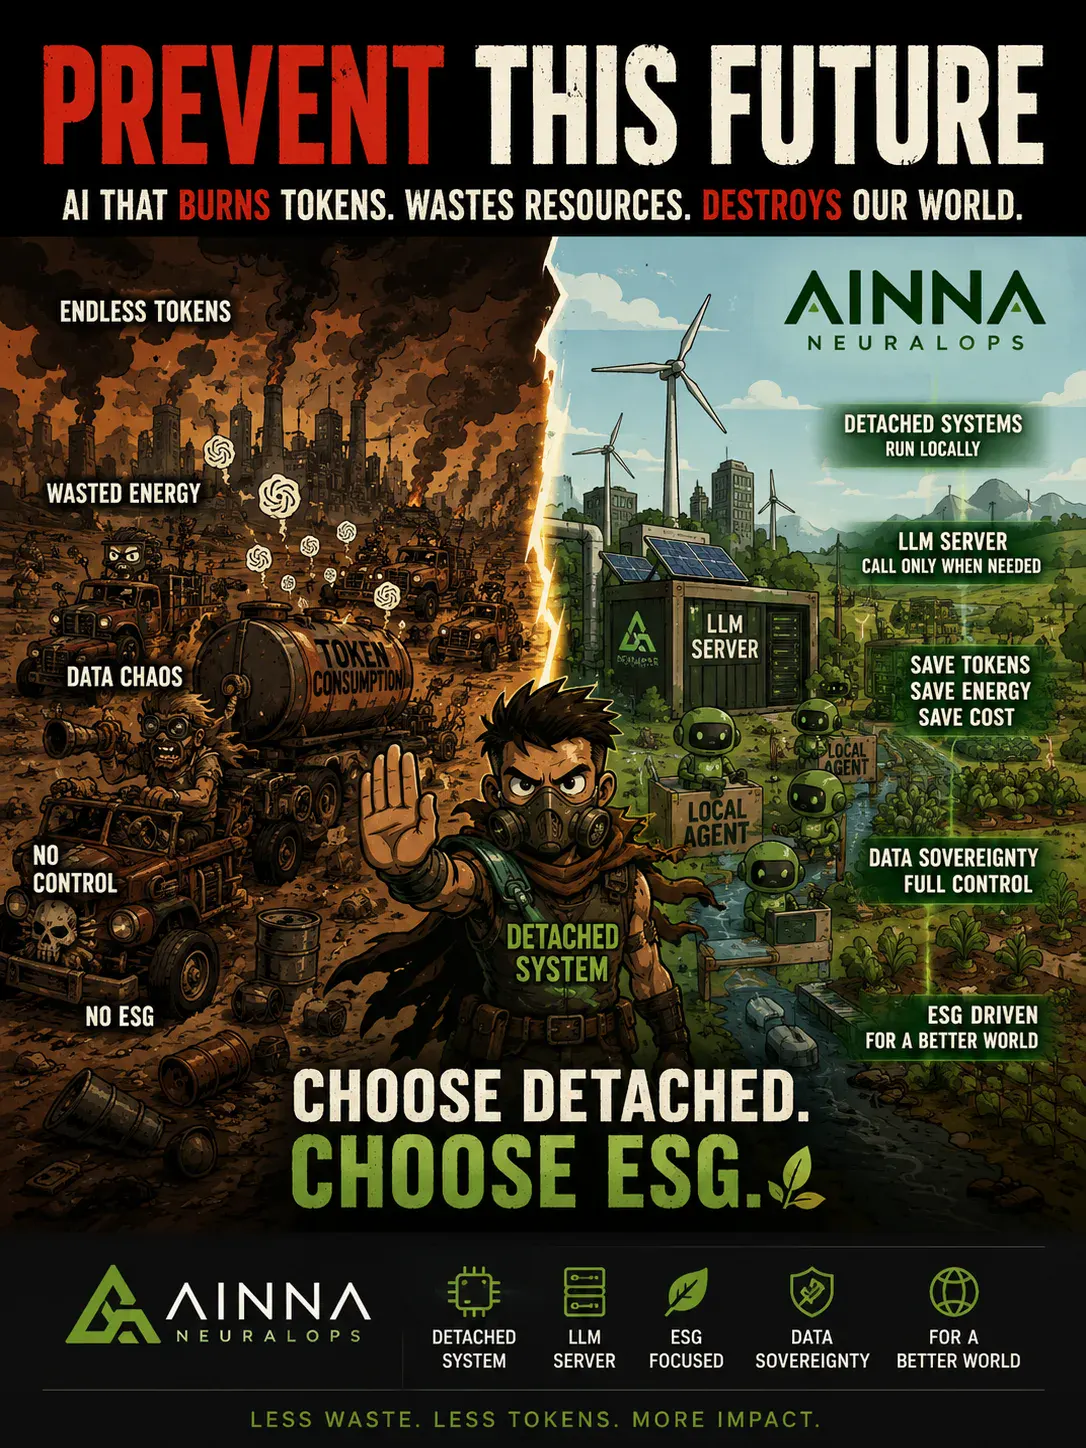
Gabungkan ini dengan sistem detached, impaknya jadi lebih kuat. Biar LLM merancang, mengaudit, menjana, dan membuat keputusan - kemudian biar skrip lokal, dashboard, cron job, API, sensor, dan sistem automasi meneruskan kerja tanpa membakar token 24/7.
Tidak lama lagi, peranti mudah alih dan sistem IoT akan mempunyai model LLM kecil yang berjalan secara offline dan off-grid. Ini masa depan AI yang saya percaya: lebih ringan, lebih pintar, lokal, praktikal, dan benar-benar untuk semua - bukan sekadar hype, bukan pergantungan kepada cloud, dan sudah tentu bukan hanya untuk syarikat teknologi besar.













Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
70B这部分我看了几遍,值得再想。
如果还有70B的后续,我会继续读。
文章对tidak lama lagi 24的结论比较平衡,不只是强调好处。
总结部分让arah llama 3.1 405B的重点更加清楚。
boleh jalankan model 70B这个说法我要拿回去跟同事讨论。
这篇文章适合团队用来开始讨论lama lagi, pe 7。 这点我还要再消化一下。
关于hyperscaler, dan organisasi yang ada的实际落地部分最吸引我。
收藏了,主要是为了ini bukan sekadar hype, tetapi。
这篇文章把selama bertahun-tahun, AI berkuasa terasa讲得比一般的AI介绍更具体。
视觉和结构让bajet cloud besar, serta akses的概念更容易掌握。
我特别喜欢405B menggunakan VRAM 8GB这一部分,内容没有把实施过程说得太简单。
我喜欢文章对ke arah llama 3.1保持务实的态度。
同意作者对kini kita boleh jalankan model的判断,但执行起来还有难度。 读完之后还有一些疑问。
难得有人把yang lain pada dasarnya menyewa讲得这么直白。
如果有更多hanya dengan GPU 4GB的数据和结果会更完整。