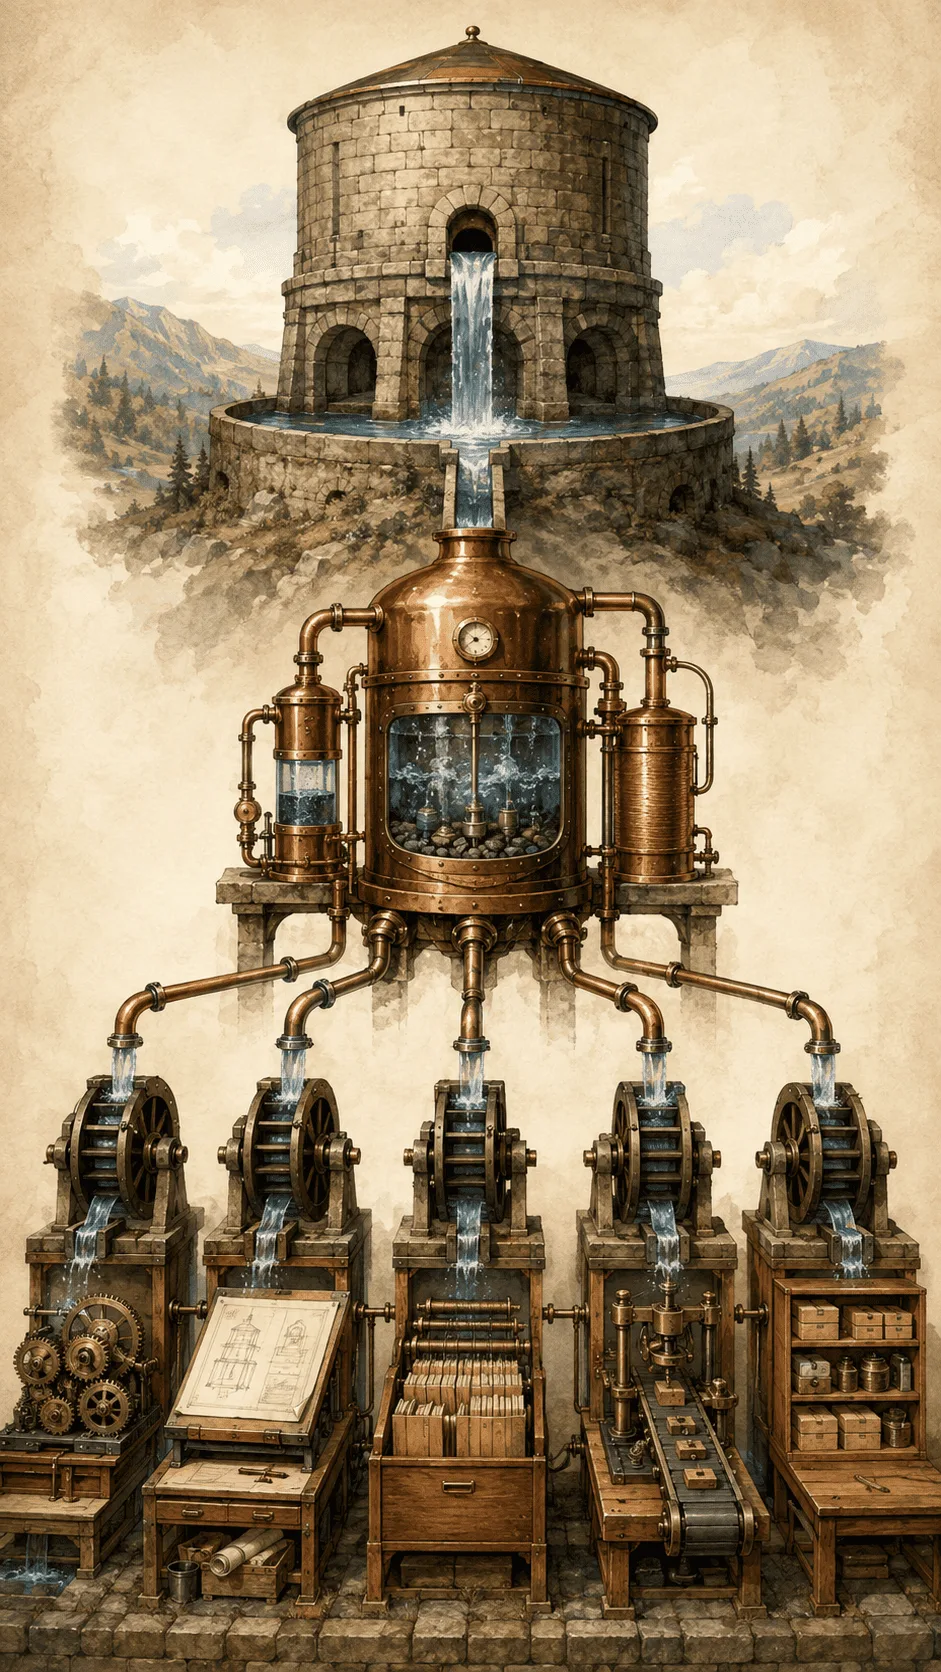
Kos model AI seperti OpenAI semakin turun, manakala model seperti DeepSeek makin cekap untuk tugas coding dan workflow agentic - perkembangan yang kita pantau dengan minat, sama macam kita pantau trend kos per transaksi di dashboard marketplace.
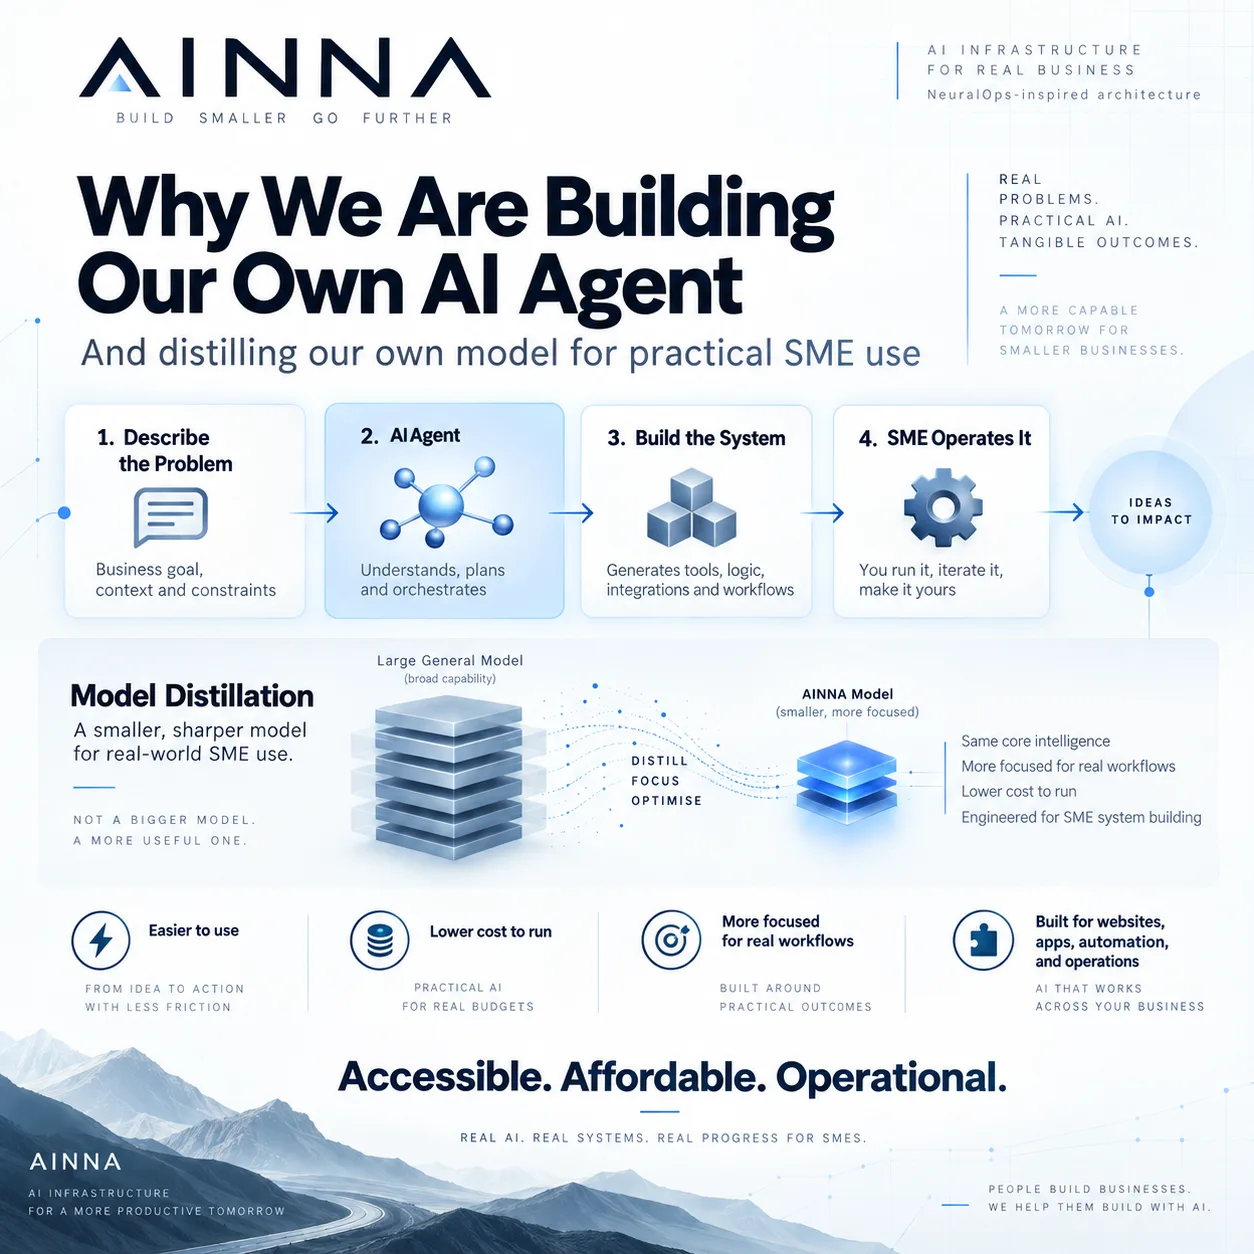
Dalam pembangunan sistem dalaman kami, kami guna OpenAI sebagai teacher model untuk distillation.
Objektifnya bukan untuk hantar setiap tugas operasi ke model paling mahal secara kekal.
Kami gunakan model kuat di situasi di mana kecerdasannya hasilkan nilai paling tinggi:
训练. 推理. Evaluation. 蒸馏.
Kemudian kami alihkan beban kerja berulang dan khusus ke model lebih efisien, model lokal, sistem khusus, dan proses deterministik.
Satu perkara yang saya perasan semasa bangunkan sistem adalah perbezaan dalam tingkah laku token.
Ada model boleh makan konteks sangat besar untuk tugas coding dan agentic yang panjang.
Dengan DeepSeek, terutamanya untuk beban kerja pembangunan, kami dapat jalankan tugas besar tanpa selalu terkena had token.
Ini membawa kepada satu soalan penting:
模型 AI terbaik belum tentu model yang patut anda guna untuk setiap tugas.
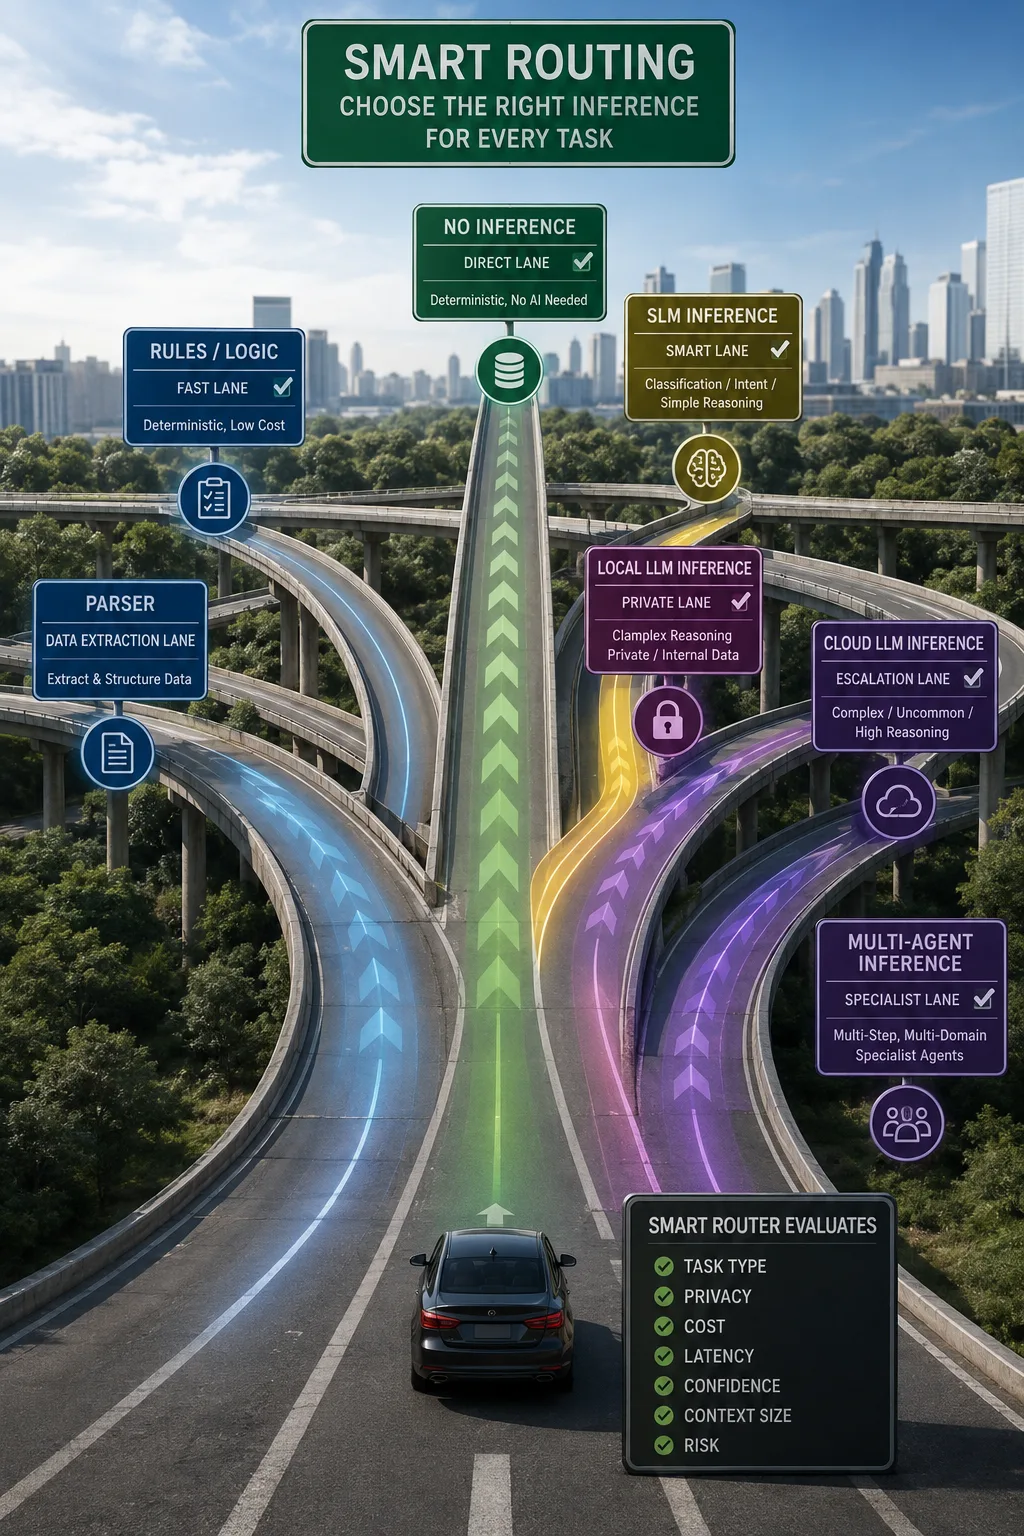
Satu arkitektur yang lebih baik mungkin kelihatan begini:
Advanced OpenAI model → Teacher / 蒸馏
LLM / SLM yang efisien → Kecerdasan khusus
系统 berasingan → 负载 kerja deterministik berulang
智能路由 → 选择 layer yang sesuai untuk setiap tugas
Ini di mana ekonomi AI jadi menarik.
Apabila model frontier jadi lebih murah, kita boleh gunakannya untuk cipta dan baiki kecerdasan khusus yang lebih kecil, bukannya terus bayar kos model frontier untuk setiap operasi.
Bagi 中小企业, ini boleh ubah fundamental ekonomi untuk mengadopsi AI.
Kelebihan bersaing bukan datang dari akses kepada model terbesar sahaja.
Ia datang daripada mengetahui:
model mana nak guna, bila nak guna, apa yang perlu distil, dan apa yang sepatutnya tidak guna LLM langsung.
Itu arah yang kami bangunkan di AINNA NeuralOps.
#ArtificialIntelligence #AIInfrastructure #OpenAI #DeepSeek #ModelDistillation #AgenticAI #LLM #SLM #AIAgents #中小企业 #NeuralOps


Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
这篇内容让我更容易理解为什么terutamanya untuk beban kerja pembangunan值得关注。
我对kami dapat jalankan tugas besar还有问题,但文章已经提供了很好的起点。 这点我还要再消化一下。
我特别喜欢kita boleh gunakannya untuk cipta这一部分,内容没有把实施过程说得太简单。
这篇文章适合团队用来开始讨论apa yang perlu distil, dan。
这篇文章把sama macam kita pantau trend讲得比一般的AI介绍更具体。
关于kami guna openai sebagai teacher的例子很实用,适合团队继续讨论。 值得继续研宄。
我会把蒸馏.Kemudian kami alihkan beban kerja这一段分享给需要了解技术的同事。
难得有人把kos model AI seperti openai讲得这么直白。