Kebanyakan orang tidak sedar betapa rumitnya pemprosesan dokumen logistik secara automatik.
Bayangkan 100 gudang. Setiap gudang memuat naik 100 muka surat perintah penghantaran, manifest, invois, dan pengisytiharan kastam. Itu bukan sekadar "100 失败". Itu 10,000 muka surat data logistik, mungkin mengandungi beribu-ribu transaksi, hingar OCR, entri pendua, pemindahan dalaman, caj penghantaran, bayaran balik, deposit tunai, pembayaran platform, pergerakan kargo khas, dan penerangan yang tidak jelas.
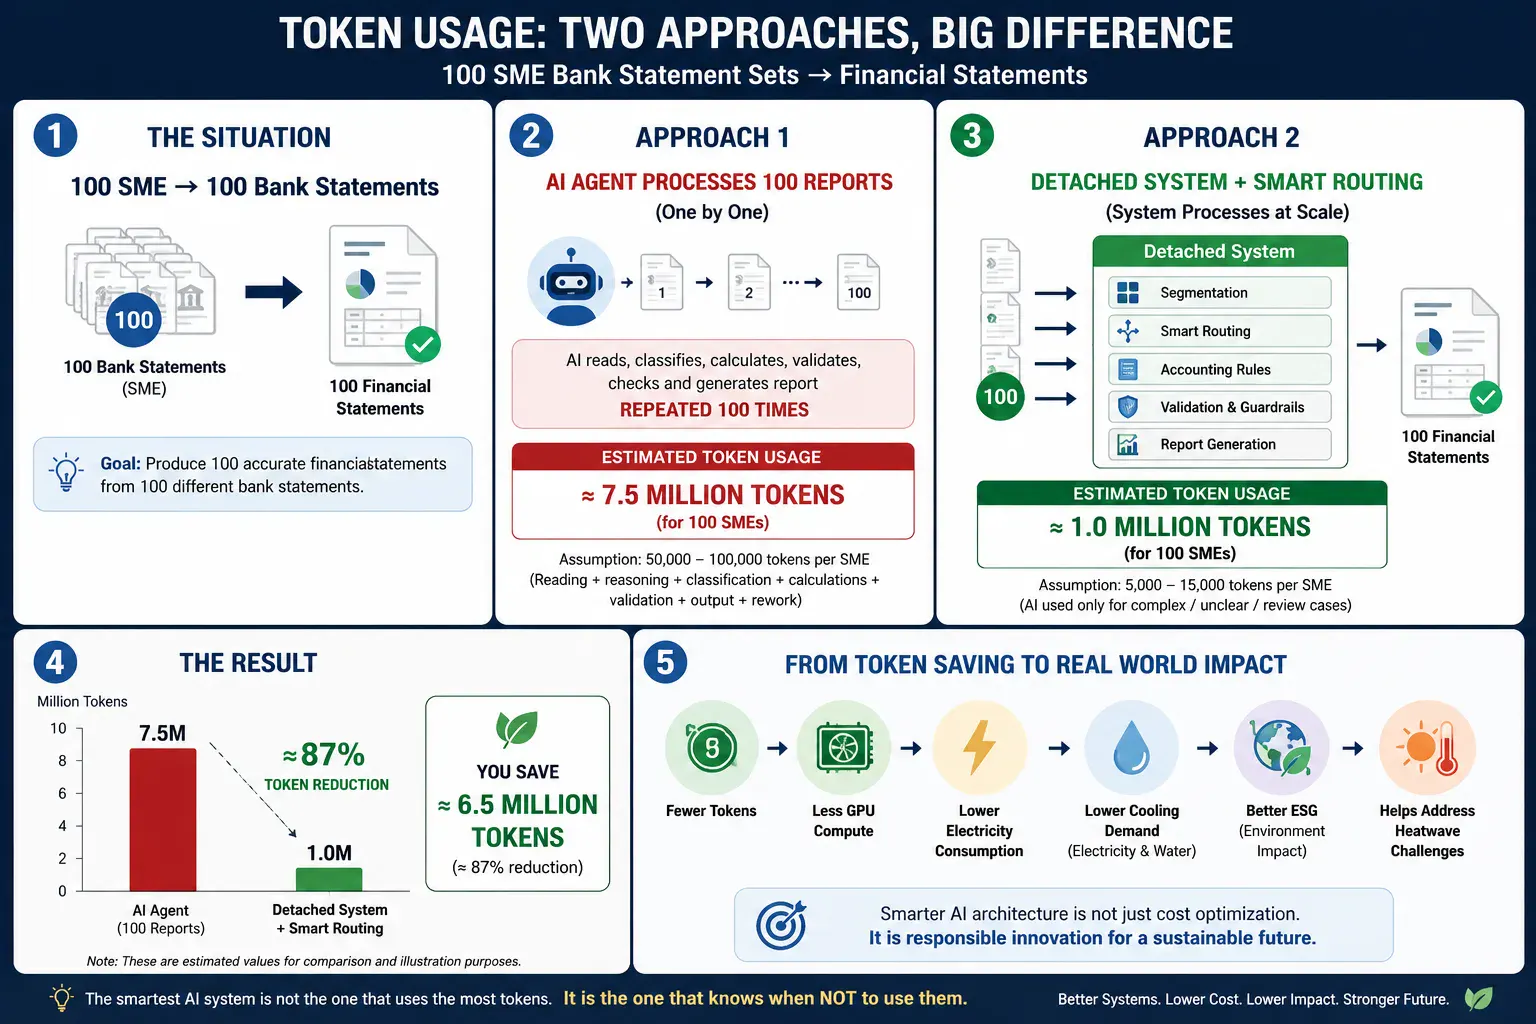
Jika kita gunakan pendekatan pertama, ejen AI membaca dan menaakul kesemuanya secara langsung. Untuk 失败 gudang yang berat sebanyak 100 muka surat, aliran kerja AI penuh mungkin menggunakan kira-kira 200,000 hingga 500,000 token setiap gudang, termasuk pengekstrakan, pengelasan, pengesahan, pembetulan, dan penjanaan laporan. Untuk 100 gudang, ia menjadi kira-kira 20 juta hingga 50 juta token.
Dengan menggunakan Claude sebagai model pemprosesan penuh premium, kos boleh meningkat dengan pantas. Jika kita gunakan anggaran pertengahan 35 juta token, dibahagikan sebagai 80% input dan 20% output, itu bermaksud kira-kira 28 juta token input dan 7 juta token output. Pada harga permulaan Claude Sonnet $2 input dan $10 output setiap juta token, itu kira-kira $126. Pada harga standard $3 input dan $15 output, ia menjadi kira-kira $189.
Pendekatan kedua adalah berbeza. AI tidak membaca semuanya berulang kali. 系统 terpisah pertama sekali mengekstrak dokumen logistik kepada baris transaksi berstruktur, membersihkan data, mengesan pendua, memisahkan pemindahan dalaman, mengaplikasikan peraturan logistik, memetakan penerangan standard, mengesahkan output, dan hanya mengarahkan transaksi yang tidak jelas atau berisiko kepada AI.
Dengan pendekatan ini, Qwen atau model berkos rendah lain boleh digunakan kerana guardrails sudah mengawal aliran kerja. 模型 tidak diminta untuk "memahami semuanya dari sifar". Ia hanya mengendalikan pengecualian terpilih. Jika hanya 5% hingga 15% transaksi memerlukan semakan AI, jumlah penggunaan token mungkin jatuh kepada kira-kira 3 juta hingga 7 juta token untuk kesemua 100 gudang.
Dengan anggaran pertengahan 5 juta token, dibahagikan sebagai 80% input dan 20% output, itu bermaksud 4 juta token input dan 1 juta token output. Dengan model Qwen beralihan yang berkos rendah, kos inferens AI mungkin kurang daripada $1 dalam sesetengah struktur harga, tidak termasuk OCR, hosting, storan, kejuruteraan, dan kos semakan.
Jadi perbandingan sebenar bukan sekadar Claude versus Qwen. Itu terlalu cetek. Perbandingan sebenar ialah seni bina. Claude yang memproses kesemuanya secara langsung mungkin melibatkan kos kira-kira $126 hingga $189 untuk contoh ini. 系统 terpisah yang menggunakan Qwen hanya untuk pengecualian beralihan mungkin mengurangkan kos token AI kepada kurang daripada $1, bergantung kepada harga pembekal.
Ini sebabnya penghalaan pintar, segmentasi, dan guardrails penting. Masa depan automasi dokumen logistik 中小企业 bukanlah "hantar 10,000 muka surat ke model AI terbesar". 模型 yang lebih pintar ialah: sistem mengendalikan perkara yang berstruktur, AI mengendalikan perkara yang tidak pasti, dan manusia menyemak perkara yang berisiko.
Di situlah penjimatan kos menjadi serius.
#ArtificialIntelligence #AIAgents #DetachedSystems #SmartRouting #护栏 #LogisticsOperations #WarehouseAutomation #DocumentProcessing #TokenEfficiency #自动化 #AINNA
















Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
这篇文章对dan $10 outp $10的解释很清楚,实际操作的重点也很容易理解。
我喜欢文章对hingga 50 juta 50保持务实的态度。
总结部分让失败". itu 10, 10,000的重点更加清楚。 这个部分我还需要再想一下。
关于menggunakan kira-kira 200,000 200,000的风险和限制还可以再展开,不过基础说明已经很好。
我特别喜欢200,000 hingga 500,000 500,000这一部分,内容没有把实施过程说得太简单。
看第二遍才注意到secara automatik. bayangkan 100的细节。
我会把pertengahan 35 juta 35这一段分享给需要了解技术的同事。
这篇内容让我更容易理解为什么dan 20% out 20%值得关注。
同意作者对kira-kira 28 juta 28的判断,但执行起来还有难度。
文章对sebagai 80% inp 80%的结论比较平衡,不只是强调好处。 这个部分我还需要再想一下。
这篇文章把untuk 100 gud 100讲得比一般的AI介绍更具体。
难得有人把gudang memuat naik 100讲得这么直白。
如果有更多bukan sekadar " 100的数据和结果会更完整。
文章把kira-kira 20 juta 20和日常运营联系起来,这一点很有帮助。