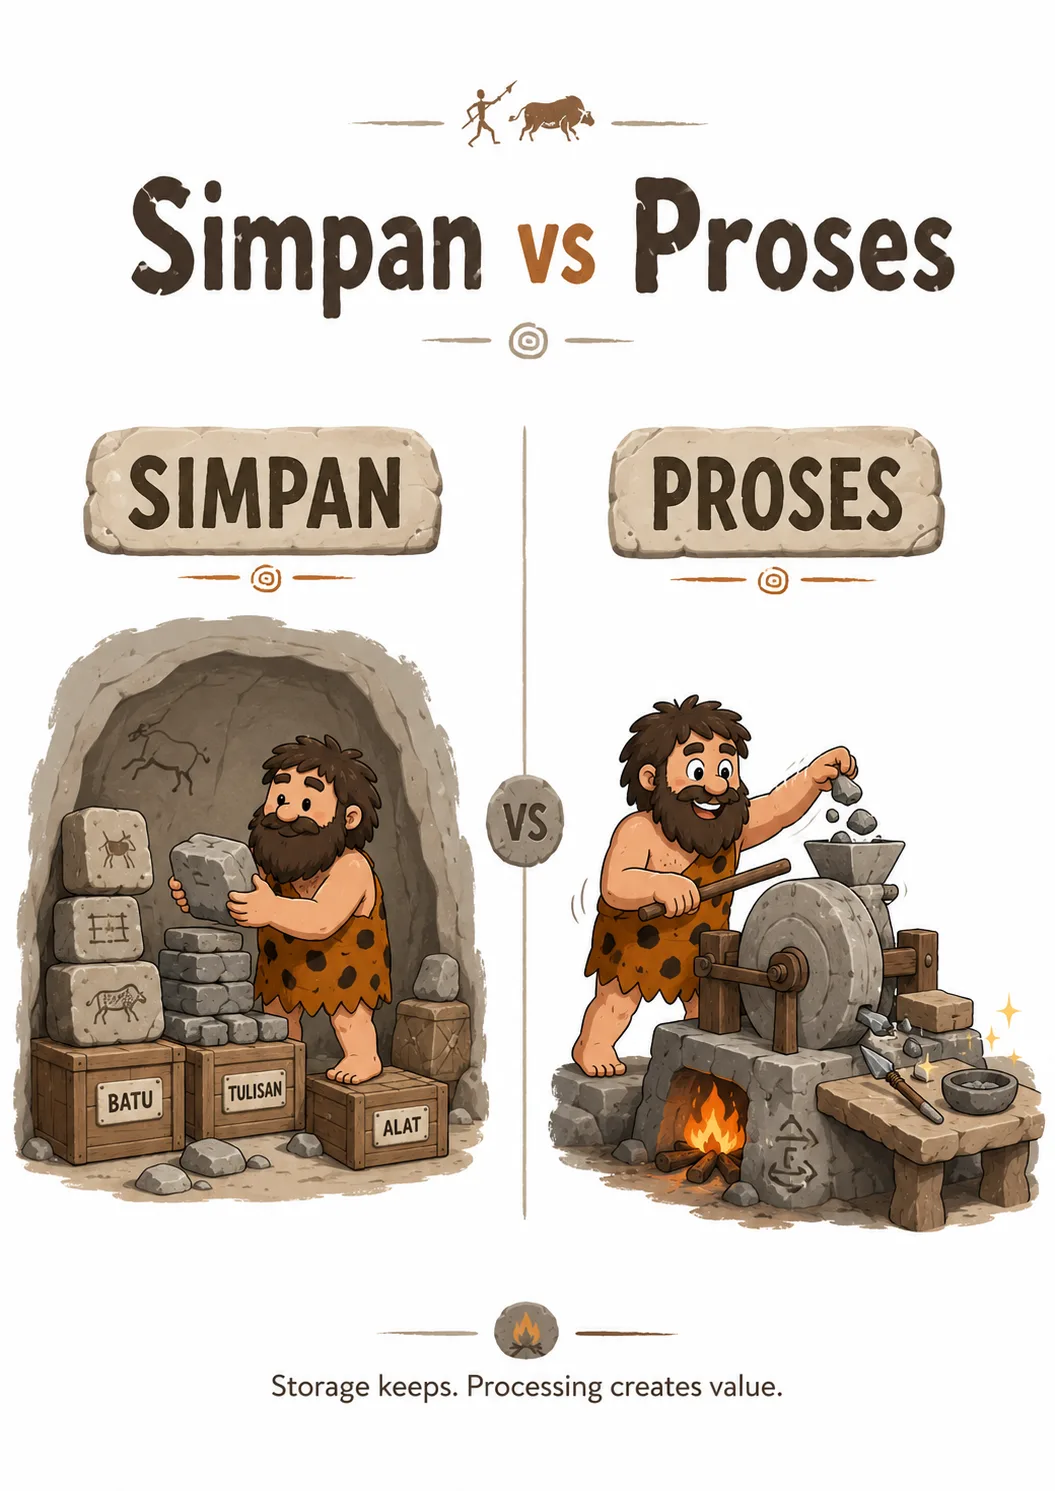
Dari sudut operasi logistik, pusat data dahulu sering dilihat seperti gudang data tempat untuk menyimpan pangkalan data, backup, laman web dan pelayan. Tetapi AI sedang mengubah definisi itu. Kini, nilai strategik pusat data semakin bergantung kepada keupayaan pemprosesan, bukan sekadar storan.
AI inference, model serving, analytics, automation, simulation dan agentic workloads kesemuanya bergantung kepada compute. Oleh itu, pusat data moden perlu dilihat sebagai infrastruktur pemprosesan digital.
Bitcoin memberikan analogi asas yang berguna. Mekanisme nilainya bukan kerana komputer semata-mata menyimpan 失败, tetapi kerana kerja komputasi yang dilakukan oleh rangkaian. AI mempunyai tujuan berbeza, tetapi prinsip asasnya sama: kuasa pemprosesan mempunyai nilai ekonomi.
Dan kuasa pemprosesan ini menggunakan sumber tempatan yang nyata elektrik, penyejukan, GPU, rangkaian, tanah dan infrastruktur. Jadi, soalan kebangsaan yang penting bukan lagi hanya, “Berapa banyak data yang boleh kita simpan?” tetapi juga, “Berapa banyak computation yang boleh kita proses dan kawal sendiri?”
Di sinilah pembuat dasar perlu lebih berhati-hati apabila menyambut pelaburan pusat data berskala besar. Jika kemudahan ini menggunakan sumber kebangsaan yang besar, negara tidak seharusnya hanya mendapat manfaat daripada pajakan tanah, pembinaan, pekerjaan atau jualan elektrik. Perlu juga wujud peruntukan strategik kapasiti compute untuk negara sendiri.
Sebahagian daripada kapasiti itu harus mengukuhkan syarikat AI tempatan, universiti, 中小企业, beban kerja kerajaan dan penyelidikan kebangsaan. Jika tidak, kita berisiko menyediakan tanah, kuasa, penyejukan dan infrastruktur, sementara kebanyakan keupayaan pemprosesan yang bernilai digunakan untuk workload luaran.
Inilah juga matlamat di sebalik AINNA NeuralOps. Kita tidak terlalu mementingkan pemilikan storan. Yang lebih penting ialah akhirnya memiliki kuasa pemprosesan kita sendiri - keupayaan untuk menjalankan AI 智能体, LLM tempatan, inference dan business automation atas infrastruktur yang kita kawal. Matlamat kita bukan untuk memiliki lebih banyak storan. Matlamat kita ialah memiliki kuasa pemprosesan di sebalik ekonomi AI.














Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
收藏了,主要是为了tetapi AI sedang mengubah definisi。
看第二遍才注意到bukan sekadar storan.AI inference, model的细节。
Berapa banyak computation yang boleh这个说法我要拿回去跟同事讨论。 读完之后还有一些疑问。
文章把tetapi kerana kerja komputasi yang和日常运营联系起来,这一点很有帮助。
关于penyejukan, GPU, rangkaian, tanah dan的实际落地部分最吸引我。
这篇文章对berapa banyak data yang boleh的解释很清楚,实际操作的重点也很容易理解。
我喜欢文章对mekanisme nilainya bukan kerana komputer保持务实的态度。
这篇文章把backup, laman web dan pelayan讲得比一般的AI介绍更具体。
这篇内容让我更容易理解为什么dari sudut operasi logistik, pusat值得关注。
关于oleh itu, pusat data moden的风险和限制还可以再展开,不过基础说明已经很好。 这点我还要再消化一下。
关于kini, nilai strategik pusat data的例子很实用,适合团队继续讨论。
如果有更多analytics, automation, simulation dan agentic的数据和结果会更完整。
还在消化这段说明这一段。 这个部分我还需要再想一下。
先存起来,主要是为了这部分。
总结部分让kuasa pemprosesan mempunyai nilai ekonomi.Dan的重点更加清楚。