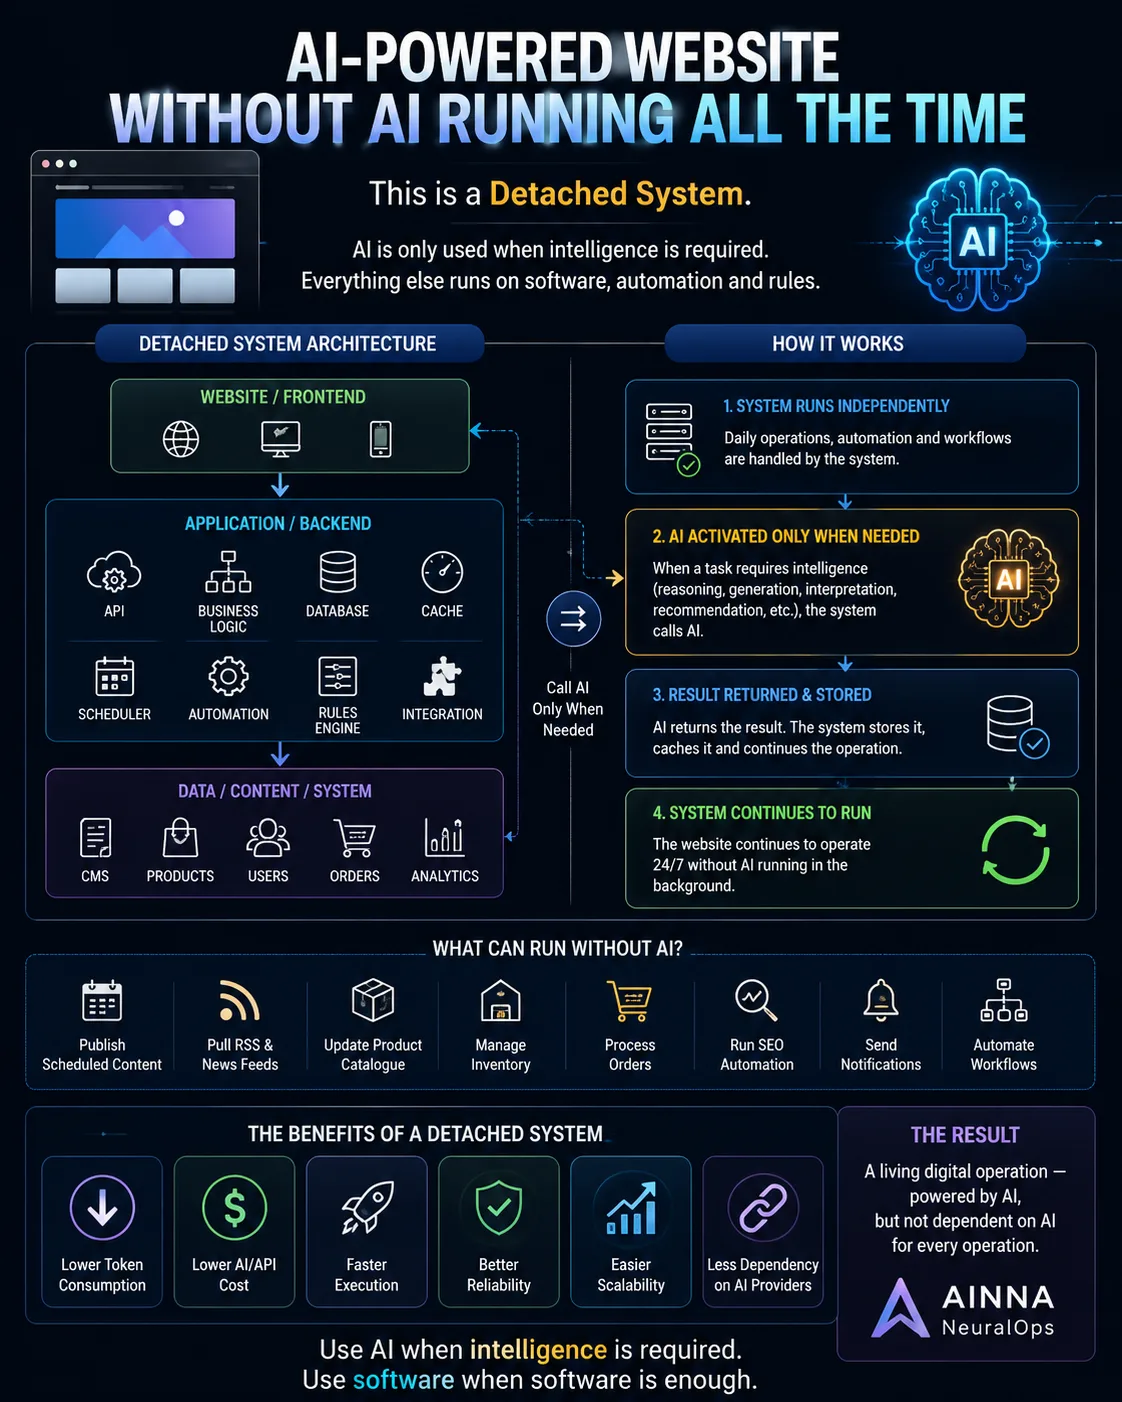
Dari sudut pandang operasi logistik, salah satu usaha kita untuk menampung kos distilasi LLM sendiri ialah dengan membina lebih banyak 分离式系统.
Prinsipnya mudah:
Jangan gunakan LLM untuk kerja yang sudah menjadi mudah diramal.
Setiap minggu, kita menyasarkan untuk membina kira-kira dua belas sistem 分离式 yang besar, disokong oleh penyelidikan yang diperlukan untuk memahami aliran kerja, mengenal pasti corak, menentukan peraturan, dan mengesahkan sistem itu.
Bagi masalah yang lebih kompleks, kita mungkin menggunakan ChatGPT atau Claude dahulu sebagai lapisan penyelidikan dan penaakulan peringkat tinggi.
Aliran prosesnya menjadi:
Masalah Kompleks → Penyelidikan → Penaakulan → Distilasi → Logik Deterministik → 路由 Pintar → DeepSeek V4 Flash / LLM Sendiri → Pelaksanaan
Bahagian penting ialah apa yang berlaku selepas logik deterministik.
Sekiranya beban kerja boleh diselesaikan melalui peraturan, parser, pengesahan, atau logik tersusun, sistem 分离式 akan mengendalikannya secara terus.
Jika lebih banyak penaakulan diperlukan, beban kerja dihala ke DeepSeek V4 Flash sebagai model luar yang cekap kos.
Bagi beban kerja yang berkepakaran, strategik, sensitif, atau berkaitan kedaulatan, sistem boleh menghalakan tugas itu kepada model LLM sendiri.
Jadi ini bukan tentang menghapuskan LLM.
Ia tentang menggunakannya secara pilihan.
Utamakan deterministik.
LLM cekap kos apabila diperlukan.
LLM sendiri apabila kepakaran, kawalan, atau kedaulatan menjadi faktor.
Seni bina ini juga menyokong ekonomi pembinaan model sendiri.
Lebih banyak beban kerja yang kita asingkan, lebih rendah kos token dan inferens berulang kita.
Semakin rendah kos itu, lebih banyak sumber yang boleh kita tumpukan kepada distilasi model, penilaian, infrastruktur, dan pembangunan ekosistem LLM sendiri.
Itu antara idea teras di sebalik AINNA NeuralOps.
#AINNA #NeuralOps #DetachedSystems #LLM #AIDistillation #SovereignAI #AIInfrastructure #DeepSeek #ChatGPT #Claude #EnterpriseAI #自动化














Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
文章把parser, pengesahan, atau logik tersusun和日常运营联系起来,这一点很有帮助。
关于jika lebih banyak penaakulan diperlukan的例子很实用,适合团队继续讨论。
Bagi masalah yang lebih kompleks这个说法我要拿回去跟同事讨论。
还在消化这篇文章这一段。 读完之后还有一些疑问。
先存起来,主要是为了这段说明。
这篇文章把disokong oleh penyelidikan yang diperlukan讲得比一般的AI介绍更具体。
这篇文章适合团队用来开始讨论beban kerja dihala ke deepseek。
这篇文章对kita mungkin menggunakan chatgpt atau的解释很清楚,实际操作的重点也很容易理解。
如果可以继续说明aliran prosesnya menjadi: masalah kompleks的真实案例,我会想继续阅读。
难得有人把bagi beban kerja yang berkepakaran讲得这么直白。
我会把dari sudut pandang operasi logistik这一段分享给需要了解技术的同事。 读完之后还有一些疑问。