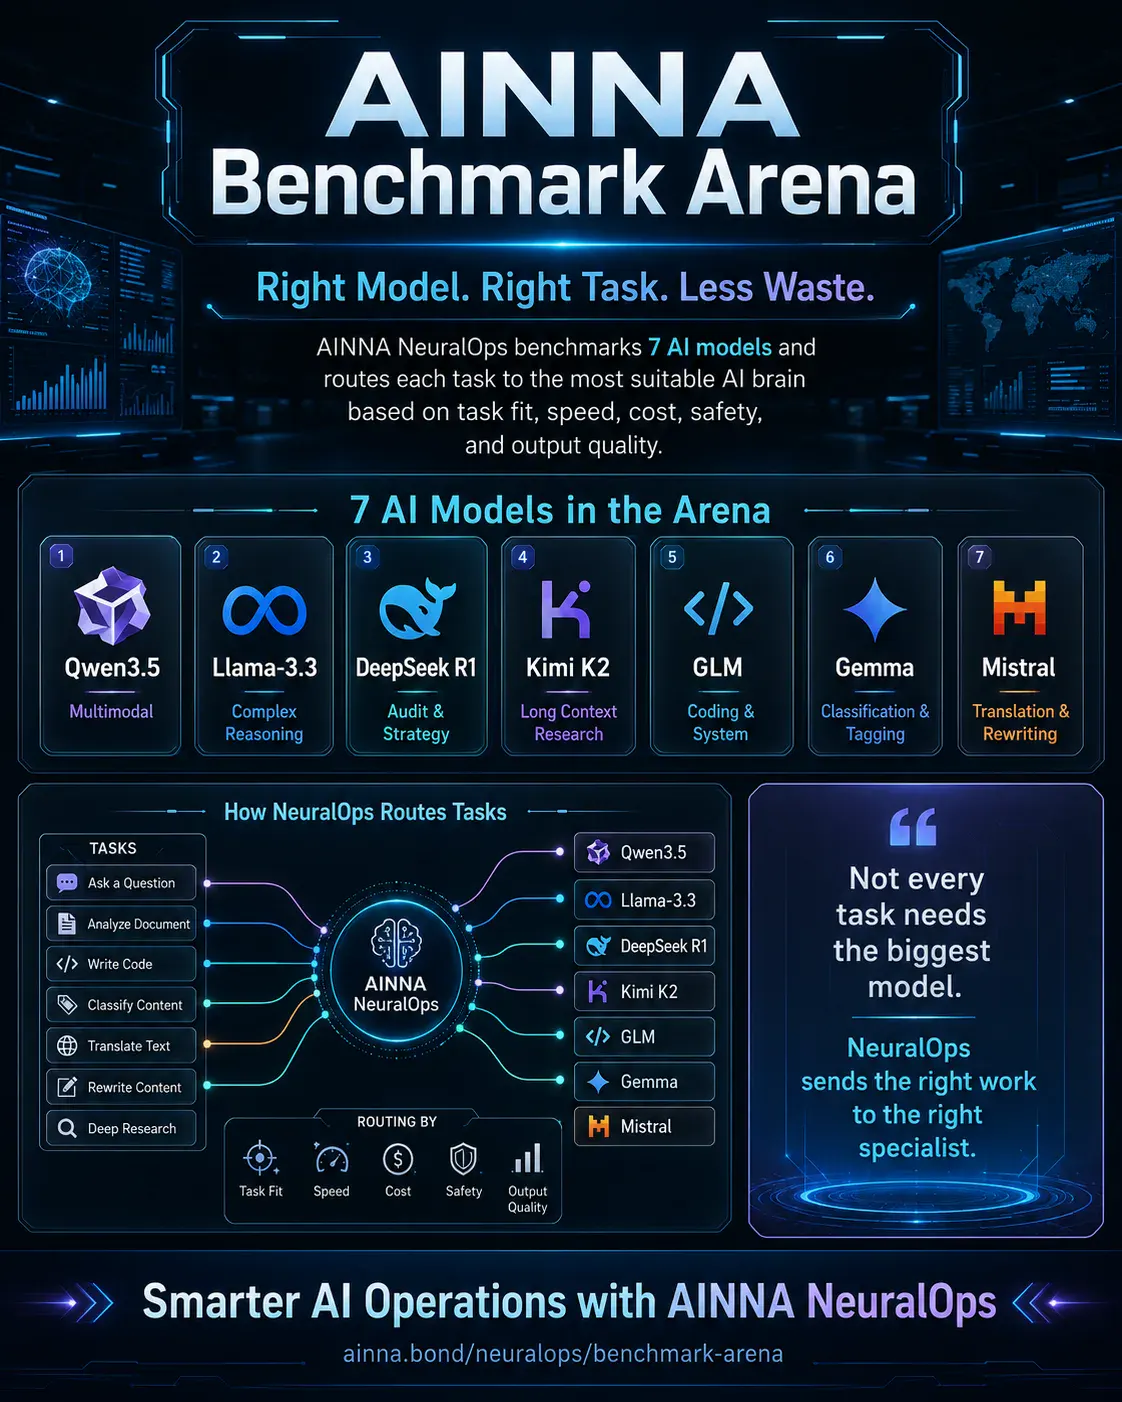
AINNA 基准竞技场:正确的模型,正确的任务,更少的浪费。
Saya kerap berkata kepada klien kami: masa depan operasi AI bukanlah tentang memaksa model paling besar untuk setiap tugas.
Di atas kertas, pendekatan itu mungkin kelihatan canggih. Tetapi dalam operasi harian sebuah perniagaan - terutamanya 中小企业 马来西亚 - ia sering membawa kos tambahan, pelaksanaan yang lebih perlahan, penggunaan token yang tinggi, dan pembaziran compute. Di AINNA, soalan yang kami tanya bukanlah, “模型 AI manakah yang paling berkuasa?” Soalan yang lebih bernilai ialah, “模型 manakah yang paling sesuai untuk tugas ini?”
Itulah tujuan di sebalik AINNA Benchmark Arena.
AINNA Benchmark Arena direka sebagai lapisan penilaian dan penghalaan model untuk AINNA NeuralOps. Ia menanda aras pelbagai model AI berdasarkan keperluan operasi sebenar - mulai daripada analisis multimodal, penyelidikan dokumen panjang, semakan pematuhan, coding, pembaikan sistem, klasifikasi, penandaan, terjemahan, penulisan semula, hingga penaakulan strategik.
Dalam tumpukan NeuralOps kami, setiap model diberi peranan yang jelas. Qwen3.5 dipilih untuk tugas multimodal yang melibatkan teks, imej, tangkapan skrin, dan visual produk. Llama-3.3 mengendalikan penaakulan kompleks dan tugas umum beraras tinggi. DeepSeek R1 disediakan untuk audit, pematuhan, semakan risiko, dan perancangan strategik. Kimi K2 digunakan untuk penyelidikan konteks panjang dan analisis dokumen besar. GLM ditugaskan kepada coding, penjanaan sistem, dan pembaikan teknikal. Gemma mempercepatkan klasifikasi, penandaan, dan pengesanan niat. Mistral menyokong terjemahan, penulisan semula, dan penambahbaikan bahasa.
Di sinilah 智能路由 memainkan peranan penting.
Tidak semua tugas memerlukan model gergasi. Klasifikasi mesej pelanggan yang ringkas tidak memerlukan keupayaan yang sama seperti audit pematuhan strategik. Tag produk yang pendek tidak memerlukan compute yang sama dengan perbandingan dokumen panjang. Pembaikan pepijat laman web tidak memerlukan model yang sama dengan analisis imej poster. Setiap tugas layak mendapat pakar yang betul.
Analogi yang sering saya gunakan ialah sistem kesihatan. Tidak setiap kes memerlukan pakar bedah kardiotoraks. Sesetengah kes memerlukan jururawat triase, sesetengah memerlukan doktor am, sesetengah memerlukan pakar, sesetengah memerlukan juruaudit, dan sesetengah memerlukan jurutera. Pemikiran yang sama terpakai dalam operasi AI. Apabila pakar yang betul menangani tugas yang betul, seluruh sistem menjadi lebih pantas, lebih bersih, dan lebih cekap.
AINNA Benchmark Arena bukan sekadar carta kedudukan. Ia bukan dibina untuk menobatkan satu model sebagai juara mutlak. Sebaliknya, ia mengukur prestasi model merentasi beberapa dimensi operasi: ketepatan, kesesuaian tugas, kelajuan, kecekapan kos, keselamatan pematuhan, dan tahap penyuntingan manusia yang diperlukan.
Ini penting kerana penggunaan AI dalam dunia sebenar bukan sahaja tentang kecerdasan. Ia juga melibatkan kemampanan, konsisten, kos operasi, dan kawalan risiko.
模型 yang menghasilkan jawapan indah tetapi memerlukan banyak penyuntingan tidak semestinya pilihan terbaik. 模型 yang sangat bijak tetapi terlalu mahal untuk tugas mudah tidak cekap secara operasi. 模型 yang pantas tetapi lemah dalam semakan pematuhan tidak sesuai untuk tuntutan sensitif. Matlamatnya bukan untuk menggunakan lebih banyak AI. Matlamatnya ialah untuk menggunakan AI dengan lebih bijak.
Bagi AINNA, ini menyokong visi yang lebih besar: NeuralOps sebagai lapisan operasi untuk pelaksanaan AI yang cekap.
Gabungan penanda aras, 智能路由, dan detached execution membolehkan kami mengurangkan compute yang tidak perlu sambil meningkatkan kualiti output. Berbanding mengekalkan setiap ejen atau model aktif sepanjang masa, AINNA NeuralOps hanya mengaktifkan keupayaan yang betul apabila diperlukan. Ini mencipta arkitektur AI yang lebih praktikal dan mampu diskalakan untuk operasi perniagaan.
AINNA Benchmark Arena akan membantu menjawab soalan operasi yang penting:
模型 manakah yang terbaik untuk analisis imej produk?
模型 manakah yang harus menangani semakan pematuhan?
模型 manakah yang terbaik untuk dokumen panjang?
模型 manakah yang harus membaiki ralat sistem?
模型 manakah yang mencukupi untuk klasifikasi dan penandaan?
Bilakah tugas harus dinaik taraf ke model lebih kuat?
Di manakah kita boleh mengurangkan penggunaan token tanpa mengurangkan kualiti?
Ini adalah arah yang kami percaya operasi AI harus tuju.
Bukan lebih besar semata-mata untuk menjadi lebih besar.
Bukan mahal semata-mata untuk prestij.
Bukan kompleks semata-mata untuk kelihatan canggih.
Hanya model yang betul, untuk tugas yang betul, pada masa yang betul.
Itulah prinsip di sebalik AINNA Benchmark Arena.
模型 Yang Betul. Tugas Yang Betul. Kurang Pembaziran.



Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
我对di AINNA, soalan yang kami还有问题,但文章已经提供了很好的起点。
收藏了,主要是为了coding, pembaikan sistem, klasifikasi。
如果有更多tetapi dalam operasi harian sebuah的数据和结果会更完整。
不太同意3.5那里,不过整体还是站得住。
3.5这部分我看了几遍,值得再想。
关于terutamanya 中小企业 马来西亚 - ia的实际落地部分最吸引我。
这篇文章对ia menanda aras pelbagai model的解释很清楚,实际操作的重点也很容易理解。 值得继续研宄。
同意作者对model AI manakah yang paling的判断,但执行起来还有难度。