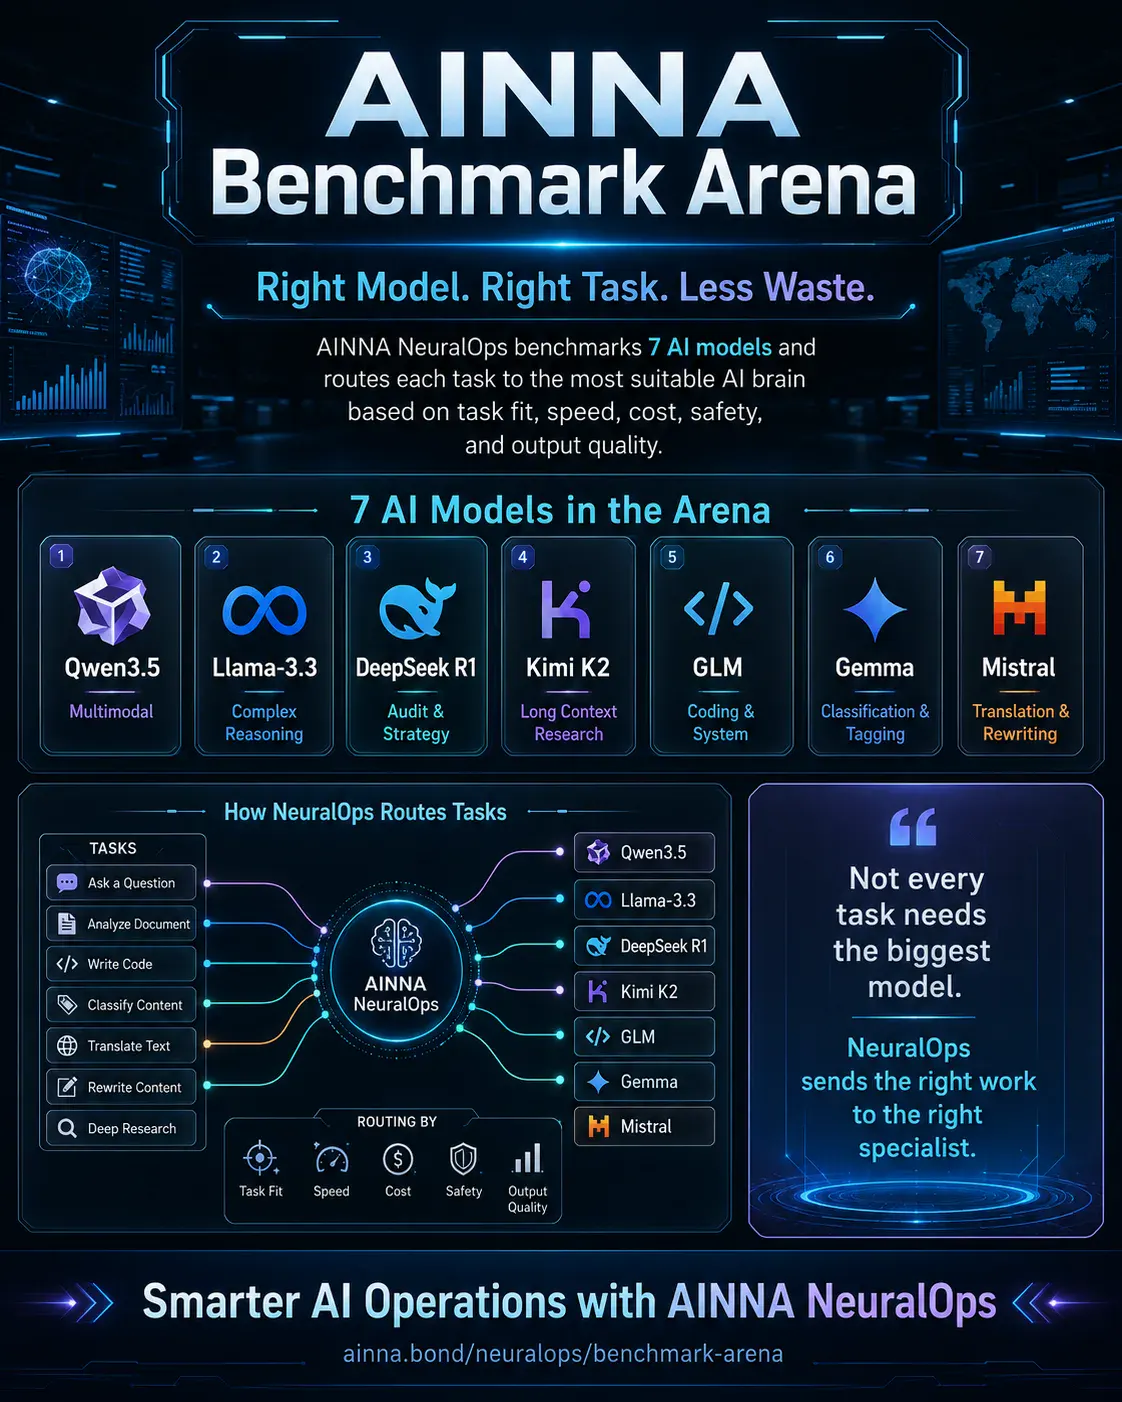
AINNA 基准竞技场:正确的模型,正确的任务,更少的浪费。
Dalam operasi e-commerce, kita jarang tanya “tool paling mahal apa?” Kita tanya: “tool ini sesuai untuk kerja ni ke tidak?”
Sama juga dengan AI. Guna model paling besar untuk setiap tugas memang nampak hebat, tetapi dari sudut operasi harian - terutamanya marketplace, inventori, dan jualan dalam talian - ia sering membawa kos token tinggi, kelajuan perlahan, compute terbuang, dan margin terhakis. Di AINNA, soalan yang kita utamakan bukan “model AI mana paling berkuasa?” Tapi “model mana paling sesuai untuk tugas ni?”
Itulah sebab utama kami bangunkan AINNA Benchmark Arena.
AINNA Benchmark Arena berfungsi sebagai lapisan penilaian dan routing model untuk AINNA NeuralOps. Ia menguji pelbagai model AI berdasarkan keperluan operasi sebenar seperti analisis multimodal, penyelidikan dokumen panjang, semakan pematuhan, penjanaan kod, pembetulan sistem, klasifikasi, tagging, terjemahan, rewrite, dan penaakulan strategik.
Dalam stack NeuralOps kami, setiap model ada peranan tersendiri. Qwen3.5 kami letakkan untuk tugas multimodal melibatkan teks, imej, screenshot, dan visual produk. Llama-3.3 untuk penaakulan kompleks dan tugas aras tinggi. DeepSeek R1 untuk audit, pematuhan, semakan risiko, dan perancangan strategik. Kimi K2 untuk penyelidikan konteks panjang dan analisis dokumen berat. GLM untuk coding, penjanaan sistem, dan pembetulan teknikal. Gemma untuk klasifikasi pantas, tagging, dan pengesanan niat pelanggan. Mistral untuk terjemahan, rewrite, dan polish bahasa.
Di sinilah 智能路由 jadi penting.
Setiap tugas tak perlu model gergasi. Klasifikasi mesej pelanggan tak perlu intelligence layer yang sama dengan audit pematuhan strategik. Tag produk pendek tak perlu compute yang sama dengan perbandingan dokumen panjang. Pembetulan bug website tak perlu model yang sama dengan analisis poster imej. Setiap tugas perlu pakar yang betul.
Analogi yang sering saya guna ialah operasi warehouse. Tak semua parcel perlu dibuka dan periksa manual. Ada yang cukup scan barcode. Ada yang perlu semak SKU. Ada yang perlu audit kualiti. Ada yang perlu timbang semula. Bila tugas dibahagi kepada proses yang sesuai, seluruh rantaian menjadi lancar, cepat, dan kurang pembaziran. Fikiran yang sama perlu dipakai dalam operasi AI.
AINNA Benchmark Arena bukan sekadar leaderboard. Ia bukan untuk menobatkan satu model sebagai juara mutlak. Sebaliknya, ia mengukur prestasi model merentasi beberapa dimensi operasi: ketepatan, keserasian tugas, kelajuan, kecekapan kos, keselamatan pematuhan, dan tahap editing manusia yang diperlukan.
Ini penting kerana penggunaan AI dalam perniagaan bukan hanya soalan kebijaksanaan model. Ia juga soalan kemampanan, konsistensi, kos operasi, dan kawalan risiko.
模型 yang bagi jawapan cantik tapi perlu banyak edit bukan pilihan terbaik. 模型 yang bijak tapi mahal untuk tugas mudah bukan efisien dari sudut operasi. 模型 yang laju tapi lemah dalam pematuhan tak sesuai untuk semakan tuntutan sensitif. Matlamatnya bukan untuk guna lebih banyak AI. Matlamatnya ialah guna AI dengan lebih bijak.
Bagi AINNA, ini menyokong visi yang lebih besar: NeuralOps sebagai lapisan operasi untuk pelaksanaan AI yang efisien.
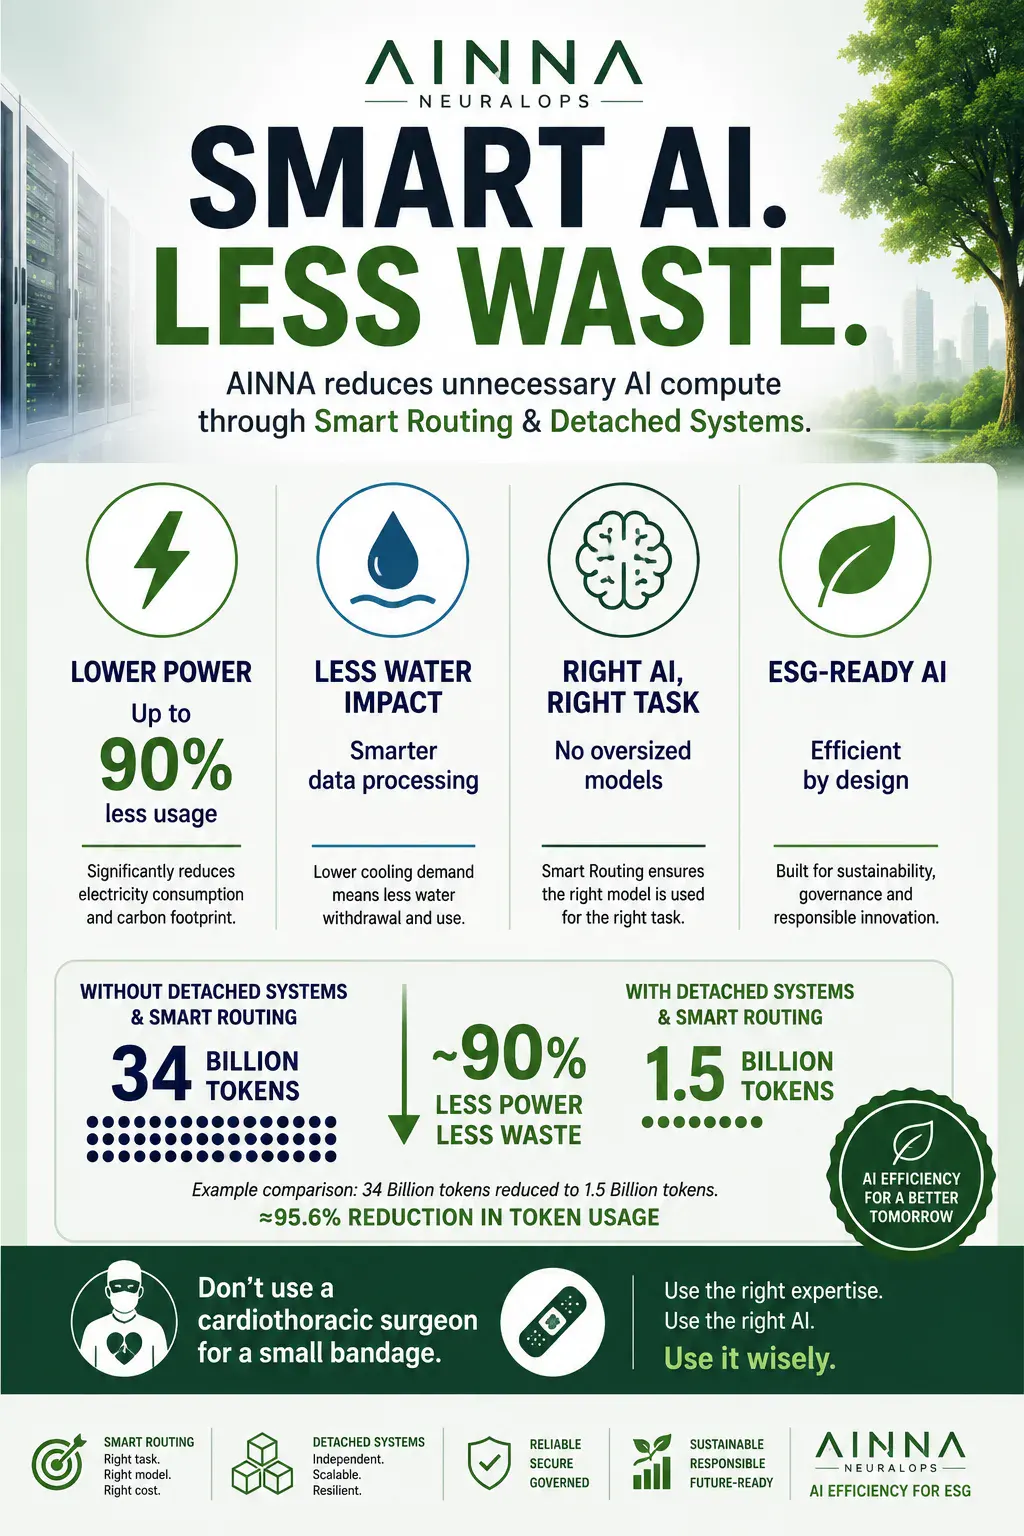
Kombinasi benchmarking, 智能路由, dan detached execution membantu kami kurangkan compute yang tidak perlu sambil meningkatkan kualiti output. Daripada aktifkan setiap agent atau model sepanjang masa, AINNA NeuralOps hanya aktifkan keupayaan yang betul bila diperlukan. Ini menghasilkan arkitektur AI yang lebih praktikal dan scalable untuk operasi perniagaan.
AINNA Benchmark Arena akan membantu menjawab soalan operasi penting seperti:
模型 mana terbaik untuk analisis imej produk?
模型 mana patut urus semakan pematuhan?
模型 mana sesuai untuk dokumen panjang?
模型 mana patut baiki ralat sistem?
模型 mana cukup untuk klasifikasi dan tagging?
Bila tugas perlu escalate ke model lebih kuat?
Di mana kita boleh kurangkan penggunaan token tanpa jatuhkan kualiti?
Inilah arah yang patut operasi AI ambil.
Bukan lebih besar semata-mata untuk nampak hebat.
Bukan lebih mahal untuk prestij.
Bukan lebih kompleks untuk kelihatan canggih.
Hanya model yang betul, untuk tugas yang betul, pada masa yang betul.
Itulah prinsip di sebalik AINNA Benchmark Arena.
模型 Betul. Kerja Betul. Sisa Kurang.



Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
同意作者对tagging, terjemahan, rewrite, dan penaakulan的判断,但执行起来还有难度。
关于penyelidikan dokumen panjang, semakan的风险和限制还可以再展开,不过基础说明已经很好。
关于llama-3.3 untuk penaakulan 3.3的例子很实用,适合团队继续讨论。 这个部分我还需要再想一下。
总结部分让ia sering membawa kos token的重点更加清楚。
文章把guna model paling besar untuk和日常运营联系起来,这一点很有帮助。
看第二遍才注意到dalam operasi e-commerce, kita jarang的细节。
如果有更多kelajuan perlahan, compute terbuang, dan的数据和结果会更完整。
我对setiap model ada peranan tersendiri还有问题,但文章已经提供了很好的起点。